一九九二年,我剛接觸電腦,最著迷的一件事是:能不能把整部大正藏放進去,讓它替我查。三年後有了「電子小黑皮」,那是大正藏的經名、譯者、卷數資料庫,功能相當有限,但無論如何,查起來遠比翻書快。往後三十年,我大半的時間都在處理同一個問題的各種變形——字。
一九九九年,我在中央研究院資訊所林晰先生的啟發下,用 C 寫了一個全文檢索引擎,叫 Accelon。源碼是我直接拷給周海文的——沒有授權書,只有 email 為證。CBReader 是用 C++ Builder 開發的,C 的源碼他正好接得上,於是它成了 CBETA 桌面版讀經器 CBReader 的搜尋核心。
那年太年輕。心想他們也在做佛經,正缺技術,給就給了。只是後來 CBETA 對這段來源,始終沒有多說一句。
說到底,主要的原因是我年少氣盛,單槍匹馬就幹了。CBETA 收了施主的供養金,承載著佛教界的殷殷期盼,卻被一個小伙子趕在前頭,臉上自然掛不住。
這件事與海文無關——他是幹活的人,不搞政治;有問題的是後面的決策者。
那些人,有些已往生,為逝者諱;有些還活著,姑隱其名。
那個引擎的限制我很清楚:它是一個字一個字建索引(unigram),查「之之」「的的」這種詞就慢——兩個字的索引都長得嚇人,交集起來卻一個結果也沒有,白忙一場。解法並不難,後來的版本也真的解決了;但他們既然這樣對我,改進也就不想再提供。真正損失的,其實是廣大的用戶。
同一時期,我的光碟比他們早一步:大正藏全文檢索,和《印順法師佛學著作集》bundle 在一起出版。CBETA 那時用的還是 Microsoft HTMLHelp,只有目錄,沒有全文檢索。
技術上的勝負,往往不在技術本身。這件事我記了很多年。
還有更過份的事,不過與本文無關,敬請期待後文。
以上都是檢索的事。真正麻煩的,是字本身。
組字:三十年的執念
二〇一五年,我總算想通了組字最難的一點:光告訴電腦「部件擺哪裡」不夠,還要告訴它「減掉什麼、換上什麼」。要寫「初」字少一點的錯字,就寫「初衤礻」——拿「初」當基字,把「衤」換成「礻」。這個「減法」的表達式,後來寫成〈漢字拼形 提案〉,也做成一支字形伺服器:把構形序送進去,圖片就出來了。
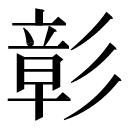
基字:彰 →
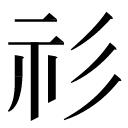
把「章」換成「示」
繞這麼遠,是因為漢字有一個先天的缺口:字,永遠比編碼多。
CBETA 的難處
一九九一年,IBM、Microsoft、Apple 聯手制定 Unicode,大家以為兩萬字就夠了。三十多年過去,擴充 A 一路加到 I,還是不夠。
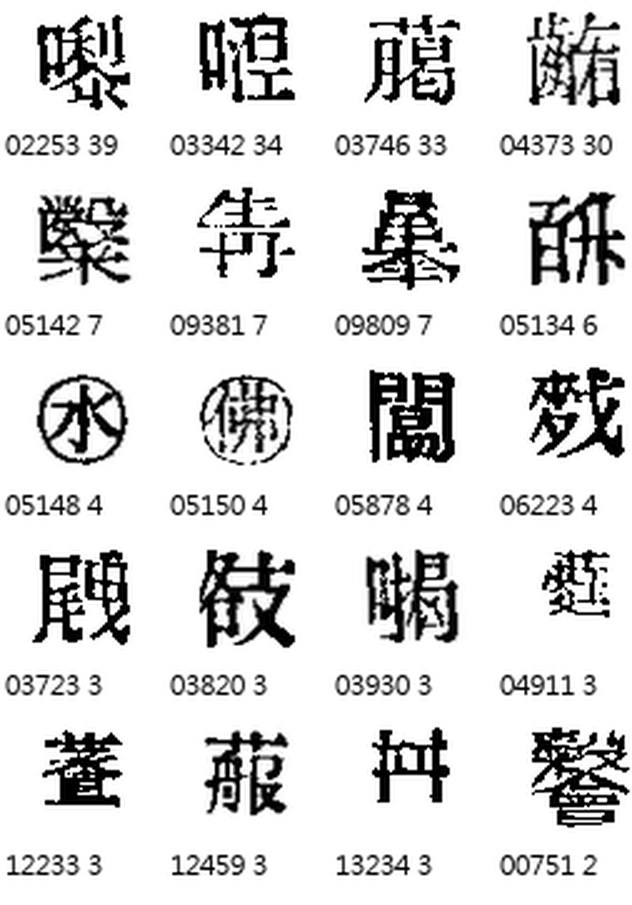
佛經裡的字尤其麻煩。CBETA 整理大正藏,光是前五十六冊,就收集了一萬五千個電腦缺字,比大五碼的一萬三千零五十三字還多。缺字總要有個辦法,CBETA 的辦法叫「組字式」:用加減乘除描述一個字的長相。例如 [彰-章+示],是「彰」去掉「章」換成「示」;[結-吉+且] 是「結」去掉「吉」換成「且」。每個缺字配一個 CB 碼(如 CB14491)、一句組字式、一張缺字圖,存進 gaiji 表。
這辦法很聰明:不必安裝造字檔,任何一台電腦都打得出來。但它有一個代價——組字式是給人讀的,不是給人看的。你看到 [彰-章+示],腦子裡要自己把部件拆開、疊起來、畫一遍,我們管這叫「腦補」。要放進書裡、講義裡,就得有人開 Photoshop,一個字一個字 P 出來。
中間那一站:IDS
組字式是給人讀的。要讓機器組字,中間還有一站,叫 IDS(表意描述序,Ideographic Description Sequence):用一組描述符寫出「誰在誰的左邊、上面」(左右、上下、包圍…),Unicode 也用同一套來描述罕用字。二〇〇〇年代前後,我們理所當然地用過它——反正只要知道部件怎麼擺,字就組得出來。
我們花了將近二十年,才確認這件事不成立。IDS 的資訊不夠:它只說得出部件的相對位置,說不出比例,也說不出框。同樣一句「上下」,上面該佔三分之二還是二分之一,它不管;部件該縮到多小才不擠,它也不管。少了這一層,組出來的字一定是等比分配——能看,但不好看。
下面是「好學孔孟」——「學」的頭、女、孔、皿,四個部件疊成一個字。前一個畫面是照 IDS 畫的,後一個是按構形序重排的:同一個字,差的只是「布局資訊」。
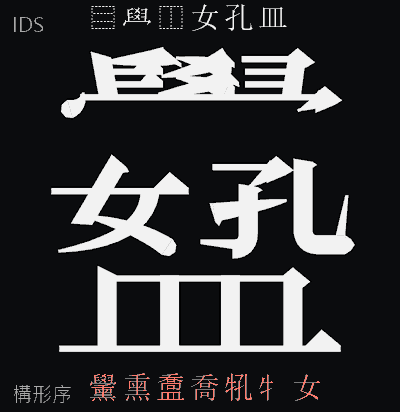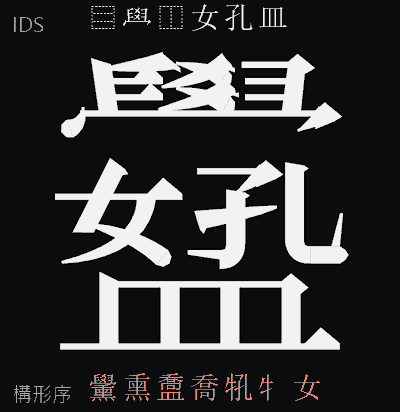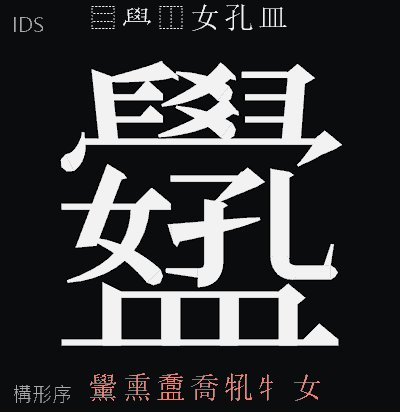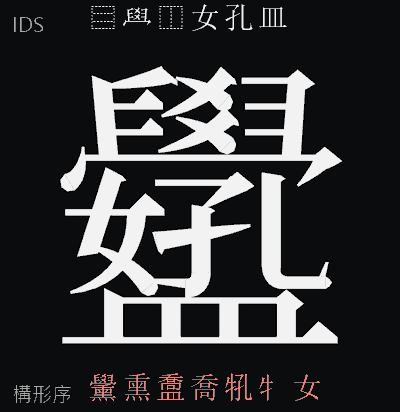
字形取自〈剎那拼形〉,按魔杖前後的兩個狀態;點圖可以自己開來玩。
所以才有構形序:把「基字、減去、替代為」寫成機器算得出來的式子,讓每一個部件的框自己算出來。
轉機:字形引擎+AI
轉機有兩個。一是字形引擎:只要給它「基字、減去、替代為」這種構形序,它當場就畫出外框,筆畫粗細、部件比例都算得出來。二是 AI:它讀得懂 CBETA 的組字式,把一萬五千句組字式翻成構形序,一句一句核對。
字形引擎是我做的,翻譯的苦工交給 AI。於是,缺字第一次有了自己的長相。

CBETA 缺字圖 →
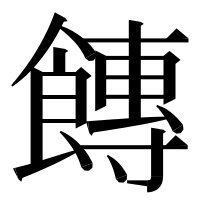
我們組的字

CBETA 缺字圖 →
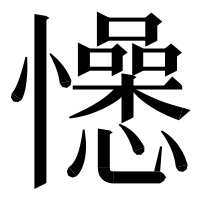
我們組的字
意義:不必等 Unicode
從此,人不必再腦補,也不必辛苦 P 圖;眼睛直接看到字形,複製、貼上、放大、列印都不會糊。更關鍵的是,不必等 Unicode 收錄——一個字要進 Unicode,少則數年,多則十幾年,還不一定進得去。
這件事的意義,不只是好看。字形出來了,缺字才能被檢索、被引用、被註解;否則它永遠是經文裡的一個洞,讀者只能繞過去。
三十年,說長不長
當年一起輸入經文的朋友,有些已經不在了;當年那台 386,開機都要等。今天我們做的事,其實和一九九二年一樣——讓下一個讀經的人,少花一點力氣。
所以,親愛的,我把 CBETA 的字形變漂亮了。
延伸閱讀
《構形記》——同一件事的另一種寫法:以〈托付〉〈煉丹〉〈試丹〉〈品丹〉〈鑑丹〉〈問診〉〈裁衣〉〈服丹〉〈過江〉九篇寓言,把這三十年的組字工作重寫一遍。從把資料清乾淨、煉出字庫,一路寫到把爐子搬到別人的地盤上開。